AI phát hiện người học gặp khó khăn thế nào?
Mục lục
- AI phát hiện khó khăn bằng cách kết hợp nhiều loại dữ liệu
- Hệ thống tìm dấu hiệu bất thường chứ không chỉ tìm điểm thấp
- Mẫu lỗi giúp AI nhận ra người học đang vướng ở kiến thức nào
- AI biến các dấu hiệu thành mức độ rủi ro như thế nào?
- Phát hiện sớm cần theo dõi xu hướng của từng người học
- Cảnh báo của AI không phải là chẩn đoán chắc chắn
- Phát hiện chỉ có giá trị khi dẫn đến hỗ trợ phù hợp
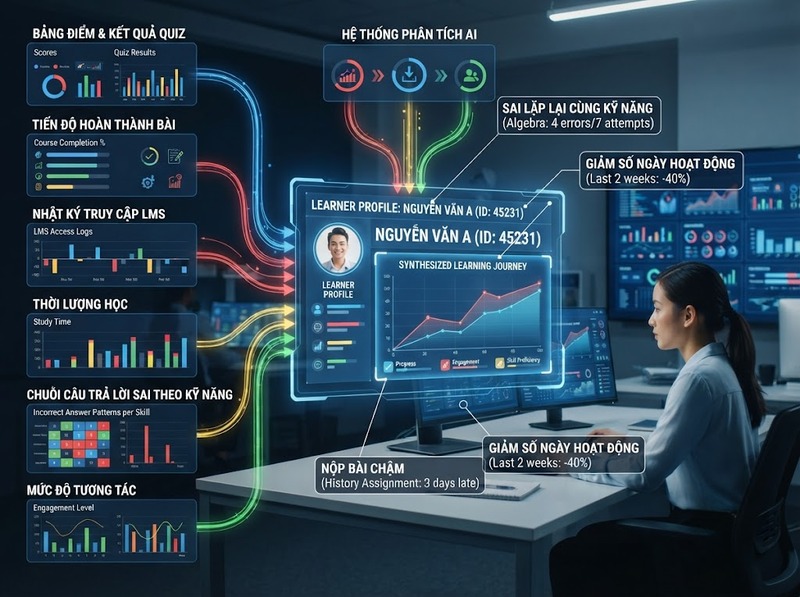
AI có thể phát hiện người học gặp khó khăn bằng cách kết hợp dữ liệu kết quả học tập, hành vi trên LMS, tiến độ, mẫu lỗi, mức độ tương tác và sự thay đổi theo thời gian. Giá trị của hệ thống không nằm ở một dấu hiệu đơn lẻ mà ở khả năng nhận ra tổ hợp tín hiệu bất thường đủ sớm để giáo viên can thiệp.
Một hệ thống thông minh không thực sự “nhìn thấy” người học đang gặp khó khăn như giáo viên quan sát trực tiếp. Nó phát hiện dấu hiệu gián tiếp được ghi lại thành dữ liệu, sau đó so sánh các dấu hiệu đó với tiến trình bình thường, lịch sử của chính người học hoặc những mẫu đã xuất hiện ở các trường hợp tương tự.
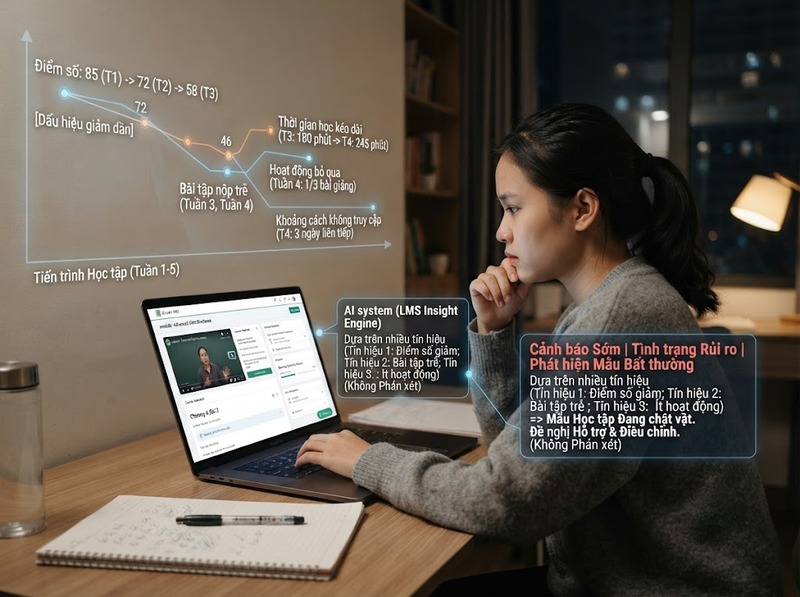
Vì vậy, việc phát hiện thường dựa trên ba thành phần kết hợp: người học đang đạt kết quả ra sao, họ đang học như thế nào và hành vi đó đang thay đổi theo thời gian thế nào. Một điểm kiểm tra thấp có thể chưa đủ để kết luận. Nhưng điểm giảm liên tiếp, thời gian hoàn thành bài tăng, bỏ nhiều hoạt động và ngừng truy cập trong nhiều ngày sẽ tạo thành một tín hiệu mạnh hơn đáng kể.
AI phát hiện khó khăn bằng cách kết hợp nhiều loại dữ liệu
Dữ liệu đầu vào quyết định hệ thống có thể nhìn thấy loại khó khăn nào. Learning analytics thường kết hợp dữ liệu về nền tảng người học, hành vi trên môi trường số, đánh giá quá trình và đánh giá tổng kết; một tổng quan hệ thống về learning analytics cũng cho thấy việc nhận diện người học có nguy cơ thường cần nhiều nguồn dữ liệu thay vì chỉ một biến duy nhất.
Những nhóm dữ liệu quan trọng gồm:
· Kết quả học tập: Điểm bài tập, quiz, kiểm tra, tỷ lệ câu đúng, số lần không đạt yêu cầu
· Tiến độ: Bài đã hoàn thành, bài còn thiếu, mức độ chậm so với lịch học hoặc tiến độ dự kiến
· Hành vi trên LMS: Số lần truy cập, số ngày hoạt động, tài nguyên đã mở, video đã xem, hoạt động đã thực hiện
· Thời gian học: Thời điểm bắt đầu bài, thời lượng xử lý nhiệm vụ, khoảng cách giữa các phiên học, thời gian không hoạt động
· Mẫu lỗi: Loại câu hỏi thường làm sai, kiến thức nào sai lặp lại, bước nào trong quy trình thường gây thất bại
· Tương tác: Thảo luận, trao đổi với giảng viên, hoạt động nhóm hoặc hành vi tìm kiếm trợ giúp nếu hệ thống có ghi nhận
Dữ liệu nhật ký từ LMS đặc biệt hữu ích vì nó ghi lại quá trình trước khi kết quả cuối cùng xuất hiện. Các nghiên cứu về giáo dục từ xa cho thấy log dữ liệu, hành vi trên nền tảng, thành tích, giao tiếp và hành vi bỏ học là những nhóm biến thường được phân tích trong learning analytics.
Tuy nhiên, “nhiều dữ liệu” không đồng nghĩa với “phát hiện chính xác hơn”. Một hệ thống chỉ thu thập số lượt click mà không biết click đó liên quan đến hoạt động học tập nào có thể tạo ra rất nhiều dữ liệu nhưng rất ít thông tin có ý nghĩa sư phạm.
Hệ thống tìm dấu hiệu bất thường chứ không chỉ tìm điểm thấp
Cách đơn giản nhất là đặt một ngưỡng: chẳng hạn người học chưa nộp một số nhiệm vụ bắt buộc hoặc kết quả giảm xuống dưới mức quy định thì tạo cảnh báo.
AI có thể đi xa hơn bằng cách phân tích mẫu kết hợp và sự thay đổi theo thời gian.
Ví dụ, một người học có thể vẫn đạt điểm trung bình nhưng bắt đầu xuất hiện chuỗi thay đổi:
1. Truy cập khóa học thưa dần
2. Hoàn thành bài muộn hơn bình thường
3. Thời gian xử lý cùng loại bài tăng lên
4. Lặp lại một nhóm lỗi kiến thức
5. Bỏ qua một số tài nguyên cần thiết
6. Kết quả đánh giá sau đó bắt đầu giảm
Từng dấu hiệu riêng biệt có nhiều cách giải thích. Người học ít đăng nhập có thể đơn giản là tải tài liệu xuống và học ngoại tuyến. Một bài làm lâu không nhất thiết cho thấy yếu kém. Nhưng khi nhiều tín hiệu cùng thay đổi theo một hướng, xác suất người học đang gặp trở ngại có thể tăng lên.
Nghiên cứu sử dụng dữ liệu Moodle cho dự báo bỏ học cho thấy những đặc trưng như tổng số hoạt động được ghi nhận, số ngày có truy cập và các mẫu không hoạt động có thể trở thành biến quan trọng trong mô hình dự báo.
Điểm quan trọng là AI không nên diễn giải một hành vi đơn lẻ thành một phán quyết về người học. Nó đang tìm mẫu rủi ro, không trực tiếp quan sát nguyên nhân thực sự.
Mẫu lỗi giúp AI nhận ra người học đang vướng ở kiến thức nào
Nếu hệ thống chỉ biết tổng điểm, nó chủ yếu trả lời được câu hỏi “người học đang làm tốt hay không”. Khi có dữ liệu chi tiết đến từng câu hỏi, kỹ năng hoặc bước giải, hệ thống có thể tiến gần hơn đến câu hỏi quan trọng hơn: người học đang vướng ở đâu?
Giả sử một bài kiểm tra có 20 câu. Hai người cùng đạt 60%, nhưng nguyên nhân có thể rất khác nhau.
Người thứ nhất sai rải rác ở nhiều chủ đề. Người thứ hai làm đúng gần như toàn bộ bài nhưng liên tục sai tất cả câu yêu cầu áp dụng một khái niệm cụ thể. Tổng điểm giống nhau, nhưng hồ sơ khó khăn khác nhau.
AI có thể tìm các cấu trúc như:
· Một loại lỗi xuất hiện lặp lại
· Các câu hỏi cùng kỹ năng đều có xác suất sai cao
· Người học làm đúng kiến thức tiền đề nhưng thất bại ở bước vận dụng
· Cùng một lỗi vẫn tồn tại sau khi đã xem lại tài liệu
· Nhiều lần thử không tạo ra sự cải thiện
· Khó khăn ở một kiến thức tiền đề kéo theo lỗi ở các nội dung phía sau
Đây là khác biệt giữa phát hiện nguy cơ và chẩn đoán dấu hiệu học tập. Risk prediction có thể nói “người học này cần được chú ý”; phân tích mẫu lỗi giúp giáo viên biết nên chú ý điều gì.
Dù vậy, dữ liệu hành vi vẫn chỉ là dấu vết của quá trình học. Một mẫu lỗi không tự động chứng minh nguyên nhân là thiếu kiến thức. Người học cũng có thể gặp vấn đề về cách hiểu câu hỏi, ngôn ngữ, thời gian, công nghệ hoặc hoàn cảnh học tập.
AI biến các dấu hiệu thành mức độ rủi ro như thế nào?
Một hệ thống dự báo thường vận hành qua một chuỗi xử lý.
Trước hết, dữ liệu thô được thu thập từ LMS, hệ thống đánh giá hoặc những môi trường học tập liên quan. Sau đó hệ thống chuyển chúng thành các đặc trưng có thể phân tích, chẳng hạn:
· Số ngày không truy cập
· Tỷ lệ nhiệm vụ hoàn thành
· Điểm trung bình trong vài tuần gần nhất
· Mức thay đổi điểm so với giai đoạn trước
· Số lần nộp muộn
· Tần suất làm lại bài
· Tỷ lệ sai của từng nhóm kỹ năng
Mô hình tiếp tục tìm mối quan hệ giữa những đặc trưng này và kết quả cần dự báo, chẳng hạn không hoàn thành môn, thất bại ở đánh giá tiếp theo hoặc rơi vào nhóm cần hỗ trợ.
Đầu ra có thể là một lớp phân loại như “nguy cơ thấp/cao”, một xác suất hoặc một risk score.
Ví dụ:
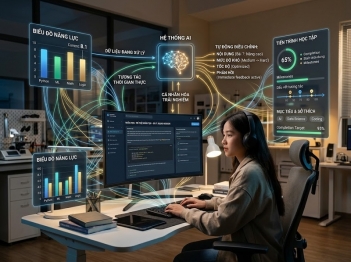
Dữ liệu học tập → Đặc trưng hành vi và kết quả → Mô hình phân tích → Xác suất rủi ro → Giải thích tín hiệu → Cảnh báo cho người có trách nhiệm hỗ trợ
Trong nghiên cứu năm 2025 sử dụng Moodle log để dự báo bỏ học, một cấu hình mô hình được báo cáo đạt F1 trung bình khoảng 0,8 qua nhiều tuần thử nghiệm. Tuy nhiên, con số như vậy không phải benchmark có thể áp dụng cho mọi trường hoặc mọi khóa học: độ chính xác phụ thuộc dữ liệu, định nghĩa “gặp khó khăn”, tỷ lệ nhóm có nguy cơ và bối cảnh triển khai.
Điều này cũng giải thích vì sao không tồn tại một ngưỡng phổ quát kiểu “đăng nhập dưới X lần thì người học gặp khó khăn”. Mỗi khóa học có thiết kế khác nhau. Một môn phụ thuộc mạnh vào LMS tạo ra dấu vết số rất khác một môn học chủ yếu diễn ra trực tiếp.
Phát hiện sớm cần theo dõi xu hướng của từng người học
Một trong những tín hiệu giá trị nhất không phải giá trị tuyệt đối mà là sự thay đổi so với chính người học đó.
Giả sử một sinh viên thông thường:
· Hoàn thành bài trước hạn
· Hoạt động bốn hoặc năm ngày mỗi tuần
· Duy trì kết quả ổn định
Nếu trong hai tuần tiếp theo người này liên tục nộp muộn, chỉ truy cập một ngày và kết quả giảm mạnh, sự thay đổi có thể đáng chú ý ngay cả khi điểm hiện tại vẫn chưa xuống mức “không đạt”.
Cách tiếp cận theo thời gian có lợi vì khó khăn thường xuất hiện như một quá trình:
Tín hiệu nhỏ → Tích lũy bất thường → Kết quả suy giảm → Nguy cơ thất bại rõ ràng
Nếu hệ thống chỉ cảnh báo ở bước cuối, nó xác nhận vấn đề nhiều hơn là phát hiện sớm vấn đề.
Các hệ thống learning analytics vì vậy có giá trị khi giúp chuyển từ phản ứng sau thất bại sang hỗ trợ trước khi thất bại trở nên nghiêm trọng. Tuy nhiên, tổng quan hệ thống về learning analytics cho thấy dù có nhiều phương pháp hỗ trợ nhận diện người học có nguy cơ, bằng chứng quy mô lớn và nghiêm ngặt về hiệu quả cuối cùng của các hệ thống này vẫn còn hạn chế.
Nói cách khác, một mô hình dự báo tốt chưa đủ chứng minh rằng người học sẽ học tốt hơn. Sau cảnh báo còn phải có một biện pháp hỗ trợ phù hợp.
Cảnh báo của AI không phải là chẩn đoán chắc chắn
Đây là giới hạn quan trọng nhất khi diễn giải hệ thống phát hiện người học gặp khó khăn.
AI có thể thấy rằng một người ít hoạt động, điểm giảm và nộp bài muộn. Nó không nhất thiết biết tại sao.
Nguyên nhân thực tế có thể là:
· Không hiểu kiến thức
· Thiếu kiến thức tiền đề
· Cách học chưa phù hợp
· Khó tiếp cận công nghệ
· Không học trực tiếp trên nền tảng nên LMS ghi nhận ít hoạt động
· Yếu tố cá nhân mà hệ thống không quan sát được
Do đó có hai loại sai số cần đặc biệt chú ý.
Dương tính giả xảy ra khi hệ thống cảnh báo một người nhưng thực tế họ không gặp khó khăn đáng kể. Âm tính giả xảy ra khi người học thực sự cần hỗ trợ nhưng dữ liệu không đủ để hệ thống nhận ra.
Một tổng quan về dashboard và predictive analytics cũng lưu ý rằng nhiều hệ thống chủ yếu dừng ở việc xác định người học có nguy cơ, trong khi khả năng giải thích mô hình và chuyển dự báo thành chỉ dẫn có thể hành động vẫn còn hạn chế.
Vì vậy, cảnh báo nên được hiểu là:
“Có đủ dấu hiệu để kiểm tra và hỗ trợ”
thay vì:
“AI đã xác định chắc chắn người học này có vấn đề.”
Phát hiện chỉ có giá trị khi dẫn đến hỗ trợ phù hợp
Một hệ thống tốt không nên kết thúc ở risk score. Mục tiêu thực tế là biến cảnh báo thành hành động có ích.
Nếu hệ thống phát hiện người học liên tục sai một kỹ năng cụ thể, phản ứng phù hợp có thể là tài liệu bổ trợ hoặc bài luyện tập cho kỹ năng đó. Nếu tín hiệu chính là mất nhịp học tập, biện pháp cần thiết có thể là nhắc tiến độ hoặc liên hệ của giáo viên. Nếu dữ liệu không đủ để xác định nguyên nhân, bước hợp lý nhất có thể chỉ là trao đổi với người học.
Chuỗi sử dụng nên là:
Phát hiện → Giải thích dấu hiệu → Kiểm tra bối cảnh → Can thiệp → Theo dõi phản ứng
Cách làm này giữ AI ở vai trò hỗ trợ quyết định thay vì biến dự báo thành quyết định tự động.
Điều đó đặc biệt quan trọng vì dữ liệu học tập là dữ liệu liên quan trực tiếp đến con người. UNESCO nhấn mạnh việc sử dụng AI trong giáo dục cần bảo vệ dữ liệu cá nhân, duy trì vai trò chủ động của con người và quan tâm đến rủi ro thiên lệch, công bằng và khả năng kiểm chứng của hệ thống.
Một hệ thống vì thế không nên thu thập mọi dữ liệu chỉ vì có thể thu thập. Nó cần biết dữ liệu nào thực sự cần cho mục tiêu hỗ trợ, ai được xem cảnh báo, người học được đối xử thế nào sau khi bị gắn cờ và bằng cách nào giáo viên có thể kiểm tra lại kết luận của mô hình.
AI phát hiện người học gặp khó khăn hiệu quả nhất khi nó không phụ thuộc vào một chỉ báo duy nhất. Hệ thống cần kết hợp kết quả, tiến độ, hành vi học tập, thời gian, mẫu lỗi và sự thay đổi theo thời gian, sau đó đánh giá xem những tín hiệu này có tạo thành một mẫu rủi ro đáng chú ý hay không.
Điểm số cho biết một phần của kết quả. Log LMS cho thấy một phần của hành vi. Mẫu lỗi cho thấy vị trí có thể đang phát sinh trở ngại. Xu hướng thời gian giúp xác định vấn đề có đang trở nên nghiêm trọng hơn hay không. AI liên kết những mảnh dữ liệu đó để tạo cảnh báo sớm.
Nhưng cảnh báo vẫn là bằng chứng để con người điều tra và hỗ trợ, không phải chẩn đoán tuyệt đối về năng lực hay hoàn cảnh của người học. Giá trị lớn nhất của hệ thống thông minh vì vậy không nằm ở việc gắn nhãn ai “có nguy cơ”, mà ở khả năng phát hiện đủ sớm, giải thích đủ rõ và giúp giáo viên đưa ra hỗ trợ phù hợp trước khi khó khăn chuyển thành thất bại.

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm