Cách thu thập dữ liệu học tập không gây gián đoạn
Mục lục
- Ưu tiên dữ liệu phát sinh tự nhiên trong quá trình học
- Chỉ hỏi người học khi dữ liệu đó không thể suy ra đáng tin cậy
- Thiết kế điểm thu thập dữ liệu ở nơi người học ít bị phân tâm
- Thu thập đúng dữ liệu cần thiết thay vì thu thập càng nhiều càng tốt
- Biến dữ liệu thu thập được thành giá trị cho chính người học
- Đo lường mức độ gián đoạn và chất lượng dữ liệu cùng lúc
- Cách triển khai quy trình thu thập dữ liệu ít gián đoạn
Thu thập dữ liệu học tập hiệu quả không có nghĩa là hỏi người học nhiều hơn. Cách tiếp cận tốt là ưu tiên dữ liệu phát sinh tự nhiên, giảm thao tác bổ sung, thu thập theo mục đích rõ ràng và chỉ can thiệp khi dữ liệu thực sự cần thiết
Điểm khó của việc thu thập dữ liệu học tập nằm ở chỗ nhà trường hoặc nền tảng cần đủ thông tin để hiểu quá trình học, nhưng người học lại không muốn liên tục dừng việc học để trả lời khảo sát, nhập biểu mẫu hay xác nhận dữ liệu.
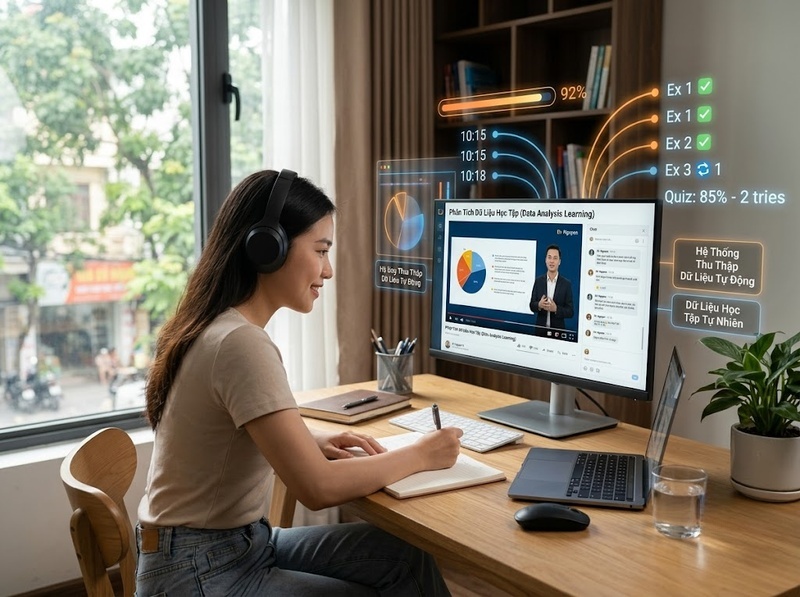
Giải pháp không phải là loại bỏ hoàn toàn việc hỏi người học. Quan trọng hơn là phân biệt dữ liệu nào có thể thu thập từ chính hoạt động học tập, dữ liệu nào cần người học cung cấp trực tiếp và thời điểm nào việc hỏi thực sự tạo ra giá trị.
Ưu tiên dữ liệu phát sinh tự nhiên trong quá trình học
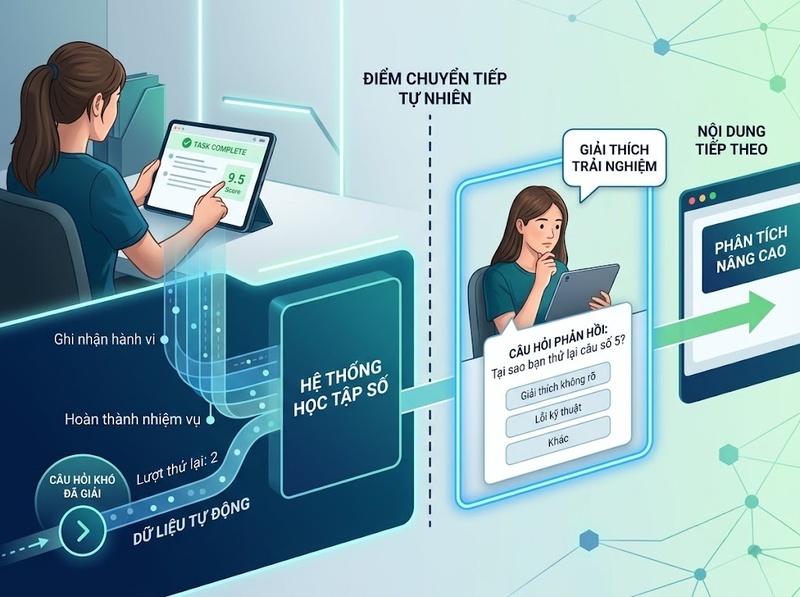
Cách ít gây gián đoạn nhất là thu thập trước những dữ liệu đã phát sinh từ hoạt động mà người học vốn đang thực hiện.
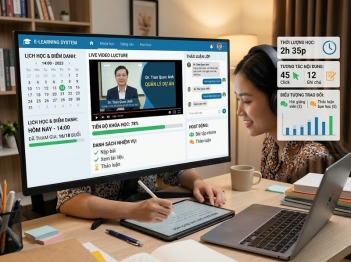
Ví dụ, một nền tảng học trực tuyến thường đã có thể ghi nhận thời điểm bắt đầu và kết thúc một hoạt động, tài nguyên được mở, bài tập được nộp, số lần thử, kết quả, tiến độ hoàn thành hoặc chuỗi hoạt động trước khi người học chuyển sang nội dung tiếp theo.
Những dữ liệu này có một lợi thế quan trọng: người học không nhất thiết phải thực hiện thêm một thao tác chỉ để tạo dữ liệu.
Về mặt thiết kế, nên xem hoạt động học tập là nguồn dữ liệu chính:
Hoạt động học → Dữ liệu sự kiện → Phân tích → Hành động hỗ trợ
Thay vì:
Hoạt động học → Dừng lại → Điền biểu mẫu → Gửi dữ liệu → Quay lại học
Sự khác biệt nằm ở mức ma sát. Càng nhiều bước bổ sung không phục vụ trực tiếp cho mục tiêu học tập, nguy cơ làm gián đoạn trải nghiệm càng cao.
Tuy nhiên, dữ liệu hành vi không phải lúc nào cũng giải thích đúng nguyên nhân. Một người học mở lại cùng một tài liệu nhiều lần có thể đang gặp khó khăn, nhưng cũng có thể đang ôn tập. Vì vậy, dữ liệu quan sát được nên được dùng để phát hiện tín hiệu cần tìm hiểu thêm, thay vì mặc định suy ra động cơ hoặc năng lực của người học.
Chỉ hỏi người học khi dữ liệu đó không thể suy ra đáng tin cậy
Không phải mọi dữ liệu đều có thể thu thập thụ động. Cảm nhận về mức độ khó, lý do người học bỏ một hoạt động, mức tự tin hoặc nhu cầu hỗ trợ thường khó suy ra chính xác chỉ từ log hệ thống.
Khi đó, câu hỏi trực tiếp vẫn cần thiết nhưng nên được dùng có chọn lọc.
Một nguyên tắc thực tế là:
Dữ liệu có thể quan sát đáng tin cậy → thu thập tự động
Dữ liệu liên quan đến trải nghiệm hoặc nhận thức bên trong → hỏi trực tiếp
Ví dụ, thay vì liên tục yêu cầu người học đánh giá từng bài học, hệ thống có thể chỉ hỏi khi phát hiện một tín hiệu cụ thể, chẳng hạn người học thử lại một nhiệm vụ nhiều lần hoặc dừng lâu ở một bước.
Khi câu hỏi xuất hiện sau một sự kiện có ý nghĩa, người học cũng dễ hiểu hơn tại sao mình được hỏi.
Cách này tạo ra một cơ chế thu thập theo điều kiện thay vì thu thập đại trà:
Tín hiệu → Kiểm tra mức cần thiết → Câu hỏi ngắn → Phản hồi trở lại hệ thống
Điều quan trọng là câu hỏi phải bổ sung thông tin mà dữ liệu hiện có chưa trả lời được. Nếu hệ thống đã biết câu trả lời từ một nguồn đáng tin cậy, việc hỏi lại chỉ làm tăng ma sát.
Thiết kế điểm thu thập dữ liệu ở nơi người học ít bị phân tâm
Ngay cả một câu hỏi ngắn cũng có thể gây gián đoạn nếu xuất hiện sai thời điểm.
Có thể xem trải nghiệm học như một chuỗi trạng thái gồm:
Tập trung → Thực hiện nhiệm vụ → Hoàn thành → Chuyển tiếp → Phản hồi
Điểm thu thập dữ liệu nên được đặt ở những đoạn chuyển tiếp tự nhiên thay vì giữa một nhiệm vụ đòi hỏi tập trung cao.
Chẳng hạn, một câu hỏi phản hồi có thể phù hợp sau khi người học hoàn thành một hoạt động, nhưng kém phù hợp khi họ đang giải một bài toán nhiều bước.
Không chỉ thời điểm, độ dài cũng quyết định mức ma sát. Một câu hỏi có mục tiêu rõ ràng thường phù hợp hơn một biểu mẫu dài yêu cầu người học cung cấp nhiều thông tin cùng lúc.
Có thể áp dụng nguyên tắc progressive disclosure: thu thập ít thông tin ở bước đầu, chỉ mở rộng khi có lý do rõ ràng.
Ví dụ:
Lần đầu: ghi nhận sự kiện học tập
Khi xuất hiện tín hiệu bất thường: hỏi một câu ngắn
Chỉ khi cần hỗ trợ chuyên sâu: thu thập thêm thông tin
Cách này vừa giảm số lần tương tác bắt buộc vừa tránh tình trạng thu thập dữ liệu quá mức ngay từ đầu.
Thu thập đúng dữ liệu cần thiết thay vì thu thập càng nhiều càng tốt
Nhiều dữ liệu hơn không đồng nghĩa với hiểu người học tốt hơn.
Một hệ thống có thể lưu hàng trăm loại sự kiện nhưng vẫn không trả lời được những câu hỏi quan trọng như: người học đang gặp khó khăn ở đâu, dữ liệu nào đáng tin cậy và hành động tiếp theo nên là gì.
Do đó, trước khi thêm một trường dữ liệu, nên xác định chuỗi:
Cần biết gì → Dữ liệu nào trả lời được → Dùng kết quả vào việc gì
Nếu không xác định được bước cuối cùng, dữ liệu đó có thể chưa cần thu thập.
Một cách kiểm soát thực tế là phân loại dữ liệu thành ba nhóm:
· Bắt buộc: cần để vận hành hoặc trả lời một câu hỏi học tập quan trọng
· Hữu ích: có thể cải thiện phân tích nhưng không cần thu thập trong mọi trường hợp
· Không cần thiết: không tạo ra quyết định hay cải thiện trải nghiệm cụ thể
Việc phân loại này cũng giúp giảm rủi ro về quyền riêng tư. Với dữ liệu người học, nguyên tắc cần thiết không chỉ là “có thể thu thập” mà còn là “có lý do để thu thập”.
Đặc biệt, nếu dữ liệu được chia sẻ với bên thứ ba hoặc sử dụng cho các mục đích khác với mục đích ban đầu, cần xác định rõ phạm vi sử dụng, quyền truy cập và cơ chế bảo vệ dữ liệu phù hợp.
Biến dữ liệu thu thập được thành giá trị cho chính người học
Một trong những cách giảm cảm giác bị theo dõi là để người học thấy dữ liệu họ tạo ra có ích cho quá trình học.
Dữ liệu có thể được chuyển thành:
Tiến độ cá nhân → Phản hồi → Gợi ý → Hành động học tập tiếp theo
Ví dụ, thay vì chỉ ghi nhận rằng một người học đã bỏ nhiều thời gian ở một chủ đề, hệ thống có thể dùng tín hiệu đó để đề xuất tài liệu bổ trợ hoặc một dạng bài luyện tập khác.
Điểm quan trọng là dữ liệu không nên kết thúc ở việc “ghi nhận để báo cáo”. Nó cần tạo thành một vòng phản hồi có ý nghĩa.
Vòng lặp tốt có thể được hình dung như sau:
Thu thập → Phân tích → Giải thích → Hỗ trợ → Quan sát kết quả → Điều chỉnh
Nếu dữ liệu được thu thập nhưng không dẫn tới bất kỳ cải thiện nào trong dạy hoặc học, chi phí về thao tác, hạ tầng và quyền riêng tư có thể không tương xứng với giá trị nhận được.
Ngoài ra, dữ liệu hành vi không nên tự động biến thành kết luận về một cá nhân. Một tín hiệu bất thường là điểm bắt đầu để kiểm tra, không phải bằng chứng đủ để gắn nhãn người học.
Đo lường mức độ gián đoạn và chất lượng dữ liệu cùng lúc
Không thể đánh giá một hệ thống thu thập dữ liệu chỉ bằng lượng dữ liệu thu được.
Một hệ thống có thể thu thập rất nhiều dữ liệu nhưng làm giảm mức độ tham gia của người học. Ngược lại, một hệ thống hỏi quá ít có thể tạo trải nghiệm tốt nhưng thiếu thông tin cần thiết.
Vì vậy, nên theo dõi đồng thời hai nhóm chỉ số.
Chỉ số về trải nghiệm
Có thể quan sát:
· Tỷ lệ người học hoàn thành hoạt động trước và sau khi thêm điểm thu thập dữ liệu
· Tỷ lệ bỏ dở tại bước xuất hiện câu hỏi
· Thời gian trung bình để hoàn thành một nhiệm vụ
· Số lần người học phải thực hiện thao tác ngoài nhiệm vụ chính
· Tần suất đóng hoặc bỏ qua yêu cầu phản hồi
Chỉ số về chất lượng dữ liệu
Có thể theo dõi:
· Tỷ lệ dữ liệu bị thiếu
· Tỷ lệ phản hồi hợp lệ
· Tỷ lệ dữ liệu trùng lặp
· Độ trễ giữa sự kiện học tập và dữ liệu được ghi nhận
· Mức độ đầy đủ của các trường dữ liệu cần thiết
· Tỷ lệ dữ liệu thực sự được sử dụng trong phân tích hoặc can thiệp
Điều cần tối ưu không phải là một chỉ số riêng lẻ mà là sự cân bằng giữa data coverage và learning friction.
Khi một thay đổi làm dữ liệu tăng nhưng đồng thời khiến nhiều người học bỏ dở hoạt động, đó không nhất thiết là một cải tiến.
Cách triển khai quy trình thu thập dữ liệu ít gián đoạn
Một quy trình thực tế có thể bắt đầu từ câu hỏi quản lý hoặc giảng dạy thay vì bắt đầu từ công nghệ.
Xác định quyết định cần được hỗ trợ
Trước tiên hãy xác định nhà trường, giảng viên hoặc hệ thống cần biết điều gì để cải thiện hoạt động dạy và học.
Chọn dữ liệu tối thiểu cần thiết
Từ quyết định đó, xác định dữ liệu nào đủ để hỗ trợ phân tích. Không bắt đầu bằng danh sách tất cả dữ liệu hệ thống có khả năng ghi nhận.
Ưu tiên dữ liệu thụ động
Tận dụng dữ liệu đã phát sinh trong quá trình học trước khi tạo thêm biểu mẫu hoặc khảo sát.
Thiết kế trigger cho dữ liệu chủ động
Chỉ yêu cầu người học trả lời khi dữ liệu cần thiết không thể suy ra đáng tin cậy hoặc khi tín hiệu cho thấy cần tìm hiểu sâu hơn.
Đặt điểm thu thập vào thời điểm chuyển tiếp
Tránh chen câu hỏi vào giữa những nhiệm vụ đòi hỏi tập trung cao.
Đo cả trải nghiệm lẫn dữ liệu
Theo dõi tác động của cơ chế thu thập lên tỷ lệ hoàn thành, thời gian học và hành vi bỏ dở, đồng thời kiểm tra chất lượng dữ liệu nhận được.
Rà soát mục đích sử dụng
Định kỳ loại bỏ những trường dữ liệu không còn tạo giá trị, đồng thời kiểm tra quyền truy cập, thời gian lưu giữ và cách dữ liệu được sử dụng.
Cốt lõi của quy trình này là chuyển từ tư duy “thu thập tối đa” sang “thu thập đủ cho một mục đích rõ ràng”.
Thu thập dữ liệu học tập không gây gián đoạn không đồng nghĩa với việc loại bỏ mọi tương tác với người học. Mục tiêu đúng hơn là xây dựng hệ thống trong đó phần lớn dữ liệu được tạo ra tự nhiên từ hoạt động học, câu hỏi chủ động chỉ xuất hiện khi cần thiết, và mỗi dữ liệu được thu thập đều có một mục đích sử dụng rõ ràng.
Khi dữ liệu được thu thập đúng thời điểm, đúng mức và được chuyển thành phản hồi hữu ích, việc phân tích có thể hỗ trợ trải nghiệm học thay vì trở thành một lớp giám sát nằm bên ngoài trải nghiệm đó.
Hỏi đáp về thu thập dữ liệu học tập
Có nên tránh hoàn toàn khảo sát người học không?
Không. Khảo sát vẫn cần thiết đối với những thông tin khó suy ra từ hành vi, chẳng hạn cảm nhận, động lực hoặc lý do đằng sau một hành vi. Vấn đề là chỉ nên hỏi những điều dữ liệu hiện có không thể trả lời đáng tin cậy
Thu thập dữ liệu tự động có phải lúc nào cũng tốt hơn không?
Không. Dữ liệu tự động giảm thao tác nhưng vẫn có thể được diễn giải sai. Một tín hiệu hành vi cần được đặt trong bối cảnh trước khi dùng để đưa ra kết luận hoặc quyết định hỗ trợ
Làm thế nào biết một cơ chế thu thập dữ liệu đang làm gián đoạn người học?
Theo dõi sự thay đổi ở các chỉ số như tỷ lệ hoàn thành, tỷ lệ bỏ dở, thời gian thực hiện nhiệm vụ và số thao tác phát sinh sau khi cơ chế thu thập được đưa vào
Có nên thu thập mọi dữ liệu mà nền tảng có thể ghi nhận?
Không. Nên bắt đầu từ mục đích sử dụng, xác định dữ liệu cần thiết và loại bỏ những dữ liệu không tạo ra giá trị rõ ràng cho dạy, học hoặc quản lý
Dữ liệu học tập có thể được dùng để tự động đánh giá người học không?
Có thể hỗ trợ đánh giá trong một số bối cảnh, nhưng tín hiệu dữ liệu không nên mặc nhiên được xem là bằng chứng đầy đủ về năng lực hoặc nguyên nhân hành vi. Những quyết định quan trọng cần có bối cảnh và cơ chế kiểm tra phù hợp

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm