Những rủi ro tự động hóa trong giáo dục
Mục lục
- Tự động hóa có thể biến công cụ hỗ trợ thành chủ thể quyết định
- Sai lệch thuật toán có thể tạo bất công trong đánh giá và cơ hội học tập
- Lệ thuộc AI có thể làm suy giảm quá trình hình thành năng lực
- Thu thập dữ liệu quy mô lớn làm tăng rủi ro riêng tư và giám sát
- Khoảng cách số có thể bị khuếch đại thay vì thu hẹp
- Tự động hóa có thể làm mờ trách nhiệm và suy yếu quan hệ giáo dục
- Rủi ro lớn nhất xuất hiện khi nhiều yếu tố cùng kết hợp
Tự động hóa có thể giúp giáo dục vận hành nhanh hơn nhưng cũng tạo rủi ro về sai lệch thuật toán, quyền riêng tư, lệ thuộc AI, bất bình đẳng và trách nhiệm khi máy móc tham gia vào các quyết định ảnh hưởng trực tiếp đến người học.
Tự động hóa trong giáo dục không chỉ là dùng phần mềm để giảm việc hành chính. Khi thuật toán tham gia chấm bài, đề xuất nội dung học, điều chỉnh độ khó, phát hiện gian lận, phân loại người học hoặc hỗ trợ quyết định tuyển sinh, hệ thống tự động bắt đầu tác động trực tiếp đến cơ hội học tập của từng cá nhân.
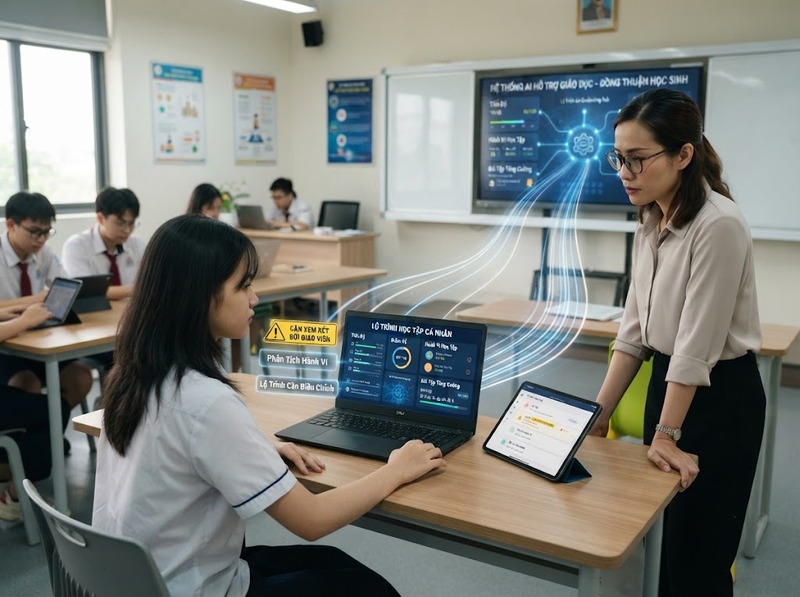
Rủi ro vì thế không nằm ở việc “có sử dụng công nghệ hay không”, mà nằm ở mức độ quyền quyết định được giao cho công nghệ, chất lượng dữ liệu và thuật toán, khả năng kiểm tra quyết định, cũng như việc con người còn giữ vai trò giám sát thực chất hay không. Chính vì những tác động có thể kéo dài đến quá trình học tập và nghề nghiệp, Đạo luật AI của Liên minh châu Âu xếp nhiều hệ thống AI dùng trong tuyển sinh, đánh giá kết quả học tập, xác định trình độ hoặc giám sát hành vi trong kỳ thi vào nhóm AI rủi ro cao.
Tự động hóa có thể biến công cụ hỗ trợ thành chủ thể quyết định
Mức rủi ro thấp nhất thường xuất hiện khi hệ thống chỉ thực hiện những tác vụ có tính hỗ trợ, chẳng hạn sắp xếp lịch học, tổng hợp tài liệu hoặc gợi ý một số hoạt động. Rủi ro tăng đáng kể khi đầu ra của hệ thống trở thành căn cứ để quyết định điểm số, năng lực, lộ trình học hoặc cơ hội tiếp cận chương trình giáo dục.
Cơ chế gây rủi ro nằm ở một điểm quan trọng: quyết định tự động thường có vẻ khách quan hơn thực tế. Một mô hình có thể đưa ra điểm số rất chính xác về mặt số học nhưng vẫn sai về mặt giáo dục nếu dữ liệu, tiêu chí hoặc giả định phía sau không phản ánh đầy đủ năng lực của người học.
Chẳng hạn, một hệ thống đánh giá tự động có thể nhận diện cấu trúc câu, từ khóa hoặc đặc điểm ngôn ngữ tốt hơn việc nhận diện tư duy sáng tạo, lập luận mới hoặc bối cảnh cá nhân. Nếu giáo viên mặc nhiên coi đầu ra của hệ thống là kết quả cuối cùng, những yếu tố mà thuật toán không đo được có thể biến thành bất lợi cho người học.
Đây cũng là lý do EU AI Act coi AI dùng để đánh giá kết quả học tập, xác định trình độ giáo dục hoặc ảnh hưởng đáng kể đến chương trình mà một cá nhân được tiếp cận là hệ thống rủi ro cao: một lỗi tưởng như kỹ thuật có thể tác động đến cả con đường giáo dục và nghề nghiệp của người học.
Vì vậy, vấn đề không phải mọi quyết định tự động đều sai. Rủi ro xuất hiện khi một dự đoán xác suất được đối xử như một phán quyết chắc chắn, đặc biệt trong những quyết định có hậu quả lớn và không có cơ chế xem xét lại bởi con người.
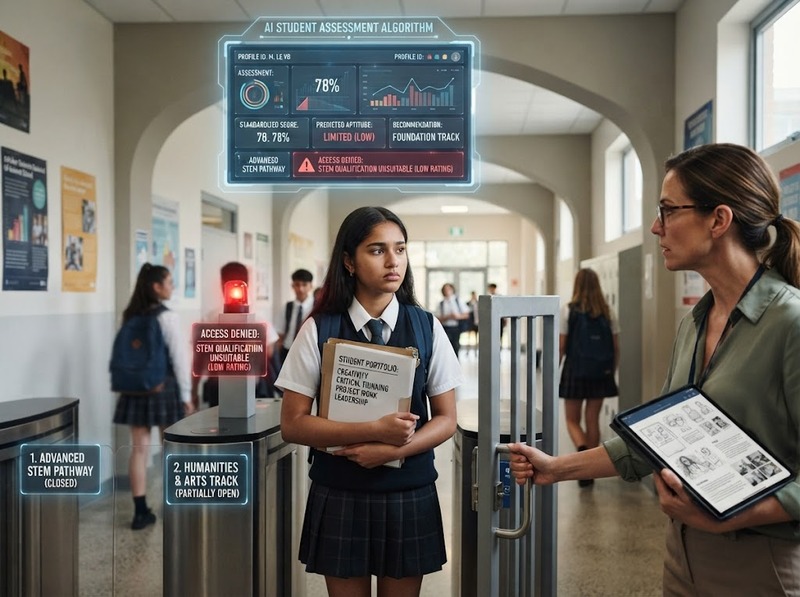
Sai lệch thuật toán có thể tạo bất công trong đánh giá và cơ hội học tập
Thuật toán học từ dữ liệu. Nếu dữ liệu quá khứ chứa chênh lệch về kinh tế, ngôn ngữ, giới, điều kiện tiếp cận công nghệ hoặc phương pháp đánh giá, hệ thống có thể học lại những chênh lệch đó thay vì loại bỏ chúng.
Điều này khiến tự động hóa có khả năng biến bất bình đẳng vốn có thành một quy trình có vẻ trung lập. Một hệ thống có thể đưa ra cùng một quy tắc cho tất cả người học nhưng vẫn tạo ra tác động khác nhau nếu dữ liệu và thiết kế ban đầu phù hợp với nhóm này hơn nhóm khác.
OECD lưu ý rằng AI trong giáo dục có thể mang lại khả năng cá nhân hóa nhưng đồng thời tồn tại các vấn đề về khả năng tiếp cận, thiên lệch vốn có trong hệ thống, quyền riêng tư, sự phù hợp văn hóa và nguy cơ làm trầm trọng thêm các chênh lệch sẵn có. UNESCO cũng cảnh báo thuật toán không mặc nhiên công bằng hay khách quan; các thiên lệch của dữ liệu và quá trình phát triển có thể tái tạo hoặc làm sâu sắc thêm phân biệt đối xử.
Rủi ro đặc biệt đáng chú ý ở những hệ thống dùng để:
· Phân loại người học theo mức năng lực
· Tự động chấm hoặc xếp hạng bài làm
· Đề xuất lộ trình học tập khác nhau cho từng nhóm
· Xác định người cần can thiệp hoặc hỗ trợ
· Phát hiện hành vi bị xem là bất thường trong kiểm tra
Một lỗi đơn lẻ trong gợi ý tài liệu thường có thể sửa dễ dàng. Nhưng cùng một sai lệch khi xuất hiện trong hệ thống phân luồng hoặc đánh giá có thể tích lũy: người học bị xếp vào mức thấp nhận nội dung ít thử thách hơn, sau đó kết quả thấp hơn lại được sử dụng để xác nhận đánh giá ban đầu. Khi đó, tự động hóa không chỉ đo năng lực mà còn có thể góp phần định hình chính năng lực mà nó đang cố đo.
Điều kiện làm rủi ro này giảm xuống là hệ thống phải được kiểm thử trên nhiều nhóm người học, có khả năng phát hiện chênh lệch kết quả và đặc biệt phải cho phép giáo viên hoặc cơ sở giáo dục xem xét lại những quyết định có ảnh hưởng lớn.
Lệ thuộc AI có thể làm suy giảm quá trình hình thành năng lực
Một trong những rủi ro khó quan sát nhất của tự động hóa giáo dục không xảy ra ngay trong điểm số mà trong quá trình người học hình thành năng lực.
Học tập đòi hỏi người học phải tự nhớ lại kiến thức, thử phương án, mắc lỗi, sửa lỗi, đánh giá nguồn tin và xây dựng lập luận. Nếu hệ thống tự động liên tục thực hiện những bước này thay người học, kết quả trước mắt có thể nhanh hơn nhưng lượng hoạt động nhận thức mà người học thực sự phải làm lại giảm xuống.
Đây là dạng “cognitive offloading” — chuyển một phần công việc nhận thức sang công cụ. Bản thân việc chuyển tải nhận thức không phải lúc nào cũng xấu; con người từ lâu đã dùng máy tính, công cụ tìm kiếm và phần mềm. Vấn đề xuất hiện khi công cụ thực hiện chính kỹ năng mà hoạt động học đang nhằm rèn luyện.
Một nghiên cứu năm 2025 trên 580 sinh viên đại học Trung Quốc ghi nhận mức phụ thuộc AI cao hơn có liên hệ với mức tư duy phản biện thấp hơn; mệt mỏi nhận thức đóng vai trò trung gian một phần trong mối quan hệ này. Đây là nghiên cứu quan sát nên không chứng minh rằng AI trực tiếp gây suy giảm tư duy phản biện, nhưng kết quả cho thấy phụ thuộc vào AI là một biến cần được quản lý trong thiết kế học tập.
Ngược lại, bằng chứng tổng hợp cũng không ủng hộ kết luận rằng sử dụng AI đương nhiên làm người học học kém hơn. Một tổng quan hệ thống và phân tích gộp công bố năm 2025 ghi nhận GenAI có thể cải thiện một số kết quả như thành tích học tập, kỹ năng ngôn ngữ và tư duy bậc cao trong những điều kiện sử dụng nhất định.
Điểm phân biệt nằm ở vai trò mà tự động hóa đảm nhận. AI giúp người học đặt câu hỏi, nhận phản hồi rồi tự sửa bài khác với AI tạo luôn câu trả lời hoàn chỉnh. Hệ thống đưa gợi ý theo từng bước khác với hệ thống loại bỏ toàn bộ quá trình giải quyết vấn đề.
Do đó, rủi ro lớn nhất không phải người học “dùng AI”, mà là người học không còn phải thực hiện đủ những thao tác nhận thức cần thiết để đạt mục tiêu học tập.
Thu thập dữ liệu quy mô lớn làm tăng rủi ro riêng tư và giám sát
Tự động hóa càng sâu thì hệ thống thường càng cần nhiều dữ liệu. Để cá nhân hóa nội dung hoặc dự đoán hành vi, nền tảng có thể xử lý lịch sử học tập, điểm số, thời gian tương tác, câu trả lời, hành vi trên thiết bị và nhiều dạng dữ liệu cá nhân khác.
Trong môi trường giáo dục, vấn đề trở nên nhạy cảm vì một phần lớn người học là trẻ em và người chưa thành niên.
UNICEF cảnh báo việc sử dụng công nghệ và dữ liệu trong trường học có thể dẫn đến xử lý dữ liệu cá nhân và dữ liệu cá nhân nhạy cảm bởi nhiều bên, gồm nhà trường, chính phủ, nhà cung cấp thứ ba và doanh nghiệp thương mại. Khi quy mô thu thập dữ liệu tăng, rủi ro đối với quyền riêng tư cũng tăng nếu thiếu các biện pháp bảo vệ phù hợp.
UNESCO cũng chỉ ra rằng tốc độ phát triển của GenAI đã vượt khả năng thích ứng của nhiều khuôn khổ quản lý, khiến cơ sở giáo dục có thể triển khai công cụ trước khi có đủ năng lực đánh giá việc bảo vệ dữ liệu người dùng.
Rủi ro không chỉ là một vụ rò rỉ dữ liệu. Nó còn bao gồm việc dữ liệu được thu thập quá mức, giữ quá lâu, chuyển cho bên thứ ba hoặc được sử dụng cho mục đích khác với mục đích giáo dục ban đầu.
Với người học nhỏ tuổi, yêu cầu còn cao hơn. Hướng dẫn AI và trẻ em của UNICEF nhấn mạnh bảo vệ dữ liệu, không phân biệt đối xử, tính minh bạch, khả năng giải thích và trách nhiệm giải trình là những yêu cầu cốt lõi của AI lấy trẻ em làm trung tâm.
Vì vậy, một hệ thống cá nhân hóa học tập không nên được đánh giá chỉ dựa trên việc “cá nhân hóa tốt đến đâu”. Cần đồng thời hỏi: nó cần bao nhiêu dữ liệu để làm điều đó, dữ liệu được giữ trong bao lâu, ai có quyền truy cập và người học có thực sự hiểu dữ liệu của mình đang được sử dụng thế nào hay không.
Khoảng cách số có thể bị khuếch đại thay vì thu hẹp
Tự động hóa thường được kỳ vọng giúp mở rộng khả năng tiếp cận giáo dục. Tuy nhiên, nếu quyền tiếp cận thiết bị, Internet, tài khoản trả phí hoặc kỹ năng sử dụng AI phân bố không đồng đều, cùng một công nghệ có thể tạo lợi thế lớn hơn cho nhóm vốn đã có nhiều nguồn lực.
Khoảng cách này không chỉ là “có máy tính hay không”. Nó còn bao gồm chất lượng thiết bị, tốc độ mạng, ngôn ngữ được hệ thống hỗ trợ, khả năng nhận biết câu trả lời sai, kỹ năng đặt yêu cầu cho AI và mức hỗ trợ từ giáo viên hoặc gia đình.
OECD xem chênh lệch tiếp cận, thiên lệch, khả năng đáp ứng văn hóa, đào tạo giáo viên và nguy cơ gia tăng bất bình đẳng hiện hữu là những vấn đề trung tâm khi AI đi vào giáo dục.
Dữ liệu TALIS 2024 cũng cho thấy mức độ sẵn sàng của hệ thống giáo dục chưa đồng đều. Tại Việt Nam, 64% giáo viên được khảo sát cho biết đã sử dụng AI trong công việc, cao hơn mức trung bình OECD là 36%. Tuy nhiên, trong nhóm giáo viên Việt Nam chưa sử dụng AI trong 12 tháng trước khảo sát, 71% cho biết trường của họ thiếu cơ sở hạ tầng để sử dụng AI.
Điều này cho thấy “triển khai tự động hóa cho tất cả” không đồng nghĩa với “mọi người học nhận được lợi ích như nhau”. Nếu một chương trình học bắt đầu giả định rằng tất cả học sinh đều có khả năng sử dụng công cụ số tương đương, những người thiếu thiết bị, kỹ năng hoặc hỗ trợ có thể bị bất lợi ngay từ thiết kế.
Rủi ro bất bình đẳng vì thế cần được đánh giá theo kết quả thực tế giữa các nhóm người học, không chỉ dựa trên việc hệ thống đã được cung cấp cho bao nhiêu người.
Tự động hóa có thể làm mờ trách nhiệm và suy yếu quan hệ giáo dục
Khi một giáo viên đưa ra đánh giá, người học biết ai chịu trách nhiệm và có thể yêu cầu giải thích. Khi một hệ thống tự động đưa ra kết quả dựa trên mô hình phức tạp, trách nhiệm có thể bị phân tán giữa nhà trường, nhà cung cấp phần mềm, người vận hành và chính thuật toán.
Câu hỏi “ai chịu trách nhiệm khi hệ thống sai?” vì vậy trở thành một vấn đề giáo dục chứ không chỉ là vấn đề kỹ thuật.
Nếu giáo viên không hiểu đủ về cách hệ thống tạo ra kết quả, họ khó phản biện đầu ra. Nếu người học không được biết rằng một quyết định có sự tham gia của thuật toán, họ thậm chí không biết mình cần yêu cầu xem xét lại điều gì.
Dữ liệu TALIS 2024 của OECD phản ánh mức độ thận trọng này. Trung bình khoảng 7/10 giáo viên được khảo sát cho rằng AI có thể giúp học sinh trình bày sản phẩm của người khác như của mình; khoảng 4/10 lo AI có thể khuếch đại thiên lệch, củng cố hiểu lầm của học sinh hoặc gây nguy cơ đối với quyền riêng tư và bảo mật dữ liệu. Đồng thời, khoảng ba phần tư giáo viên cho biết họ thiếu kiến thức hoặc kỹ năng để giảng dạy bằng AI.
Điều đó đặc biệt quan trọng vì giáo dục không chỉ là phân phối nội dung. Giáo viên còn quan sát biểu hiện, hiểu hoàn cảnh, phát hiện sự thay đổi về động lực, điều chỉnh cách giải thích và đưa ra những phán đoán có tính bối cảnh mà một hệ thống tự động khó tái tạo đầy đủ.
Tự động hóa những tác vụ lặp lại có thể giải phóng thời gian cho các hoạt động này. Nhưng nếu mục tiêu chuyển từ “giảm việc máy móc cho giáo viên” thành “thay thế phán đoán của giáo viên”, quan hệ giữa người học và người chịu trách nhiệm giáo dục có thể bị suy yếu.
Do đó, nguyên tắc quan trọng nhất khi đánh giá rủi ro là phân biệt human-in-the-loop với human-on-the-loop trên thực tế. Việc một con người có tên trong quy trình không đủ; người đó phải có khả năng hiểu, chất vấn và thay đổi quyết định của hệ thống khi cần.
Rủi ro lớn nhất xuất hiện khi nhiều yếu tố cùng kết hợp
Các rủi ro tự động hóa trong giáo dục hiếm khi tồn tại riêng lẻ. Một hệ thống đánh giá có dữ liệu thiên lệch có thể đồng thời tạo quyết định sai, ảnh hưởng cơ hội học tập và rất khó khiếu nại nếu mô hình không minh bạch. Một nền tảng cá nhân hóa có thể giúp học sinh tiến bộ nhưng cũng làm tăng thu thập dữ liệu và phụ thuộc vào thuật toán nếu được sử dụng quá mức.
Do đó, mức độ rủi ro nên được nhìn qua bốn câu hỏi:
· Quyết định này ảnh hưởng đến người học lớn đến mức nào
· Hệ thống cần bao nhiêu dữ liệu cá nhân để đưa ra quyết định
· Người học và giáo viên có thể hiểu, kiểm tra và phản biện đầu ra hay không
· Có một con người thực sự chịu trách nhiệm và có quyền thay đổi quyết định hay không
Rủi ro thấp hơn khi tự động hóa hỗ trợ một tác vụ có hậu quả nhỏ, kết quả dễ kiểm tra và con người vẫn quyết định cuối cùng. Rủi ro cao hơn khi thuật toán tự động phân loại hoặc quyết định những vấn đề ảnh hưởng lâu dài đến điểm số, quyền tiếp cận chương trình, hồ sơ học tập hoặc cơ hội phát triển.
Đây cũng là điểm chung trong cách tiếp cận của UNESCO, UNICEF và các khuôn khổ quản lý mới: AI giáo dục cần được đặt trong mô hình lấy con người làm trung tâm, bảo vệ dữ liệu, kiểm soát thiên lệch và duy trì trách nhiệm giải trình thay vì giả định rằng tự động hóa tự thân sẽ tạo ra kết quả tốt hơn.
Tự động hóa có thể giúp giáo dục giảm các công việc lặp lại, mở rộng hỗ trợ học tập và cung cấp phản hồi nhanh hơn. Nhưng khi công nghệ tham gia sâu vào đánh giá, cá nhân hóa, giám sát hoặc phân loại người học, hậu quả của sai sót cũng trở nên lớn hơn.
Những rủi ro tự động hóa trong giáo dục đáng chú ý nhất gồm sai lệch trong quyết định, suy giảm quyền tự chủ và năng lực nhận thức do lệ thuộc công cụ, xâm phạm quyền riêng tư, khuếch đại bất bình đẳng và làm mờ trách nhiệm khi xảy ra sai sót. Điểm quyết định không phải tự động hóa nhiều hay ít, mà là tự động hóa điều gì, với dữ liệu nào, ở mức hậu quả nào và con người còn khả năng kiểm soát thực chất đến đâu.

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm