Những sai lệch dữ liệu học tập thường gặp
Mục lục
- Sai lệch chọn mẫu và dữ liệu không đại diện
- Sai lệch do dữ liệu thiếu và người học không xuất hiện
- Sai lệch đo lường và dùng biến đại diện không phù hợp
- Sai lệch theo nhóm, thời gian và cách tổng hợp dữ liệu
- Sai lệch thuật toán và vòng lặp phản hồi
- Sai lệch do cách diễn giải dữ liệu
- Cách kiểm tra sai lệch dữ liệu học tập trước khi kết luận
Hiểu những sai lệch dữ liệu học tập thường gặp, từ sai lệch chọn mẫu, dữ liệu thiếu, đo lường đến sai lệch thuật toán, để tránh diễn giải kết quả học tập một cách sai lệch
Phân tích dữ liệu học tập có thể cho thấy các xu hướng rất rõ nhưng vẫn dẫn đến kết luận sai nếu dữ liệu đầu vào không đại diện, biến đo không phản ánh đúng hiện tượng hoặc quá trình thu thập dữ liệu tạo ra sai lệch. Vì vậy, cần xem sai lệch dữ liệu học tập không chỉ là lỗi kỹ thuật mà còn là vấn đề về cách dữ liệu được tạo ra, lựa chọn và diễn giải.
Sai lệch chọn mẫu và dữ liệu không đại diện
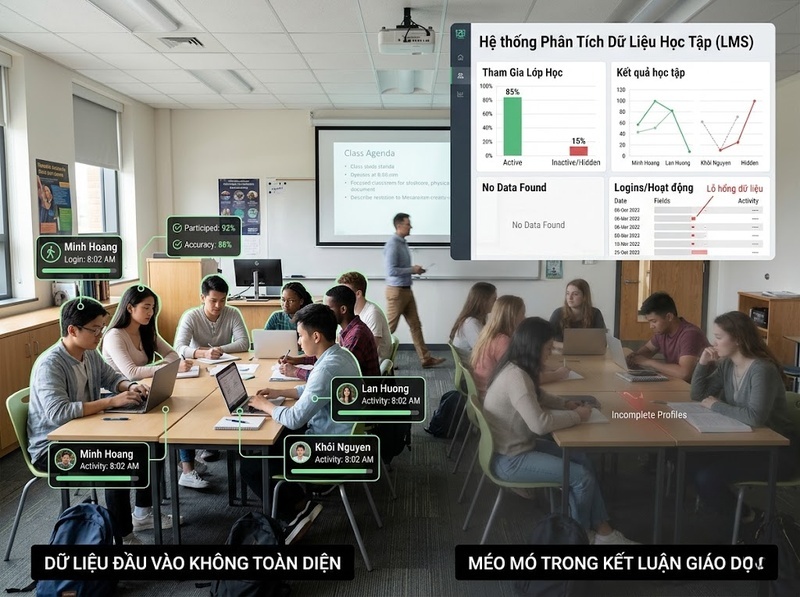
Một trong những sai lệch phổ biến nhất xuất hiện khi dữ liệu phân tích chỉ phản ánh một nhóm người học nhất định nhưng kết luận lại được áp dụng cho toàn bộ người học.
Ví dụ, nếu chỉ phân tích dữ liệu của những sinh viên thường xuyên đăng nhập hệ thống học trực tuyến, kết quả có thể đánh giá quá cao mức độ tương tác thực tế của toàn bộ lớp. Những người ít đăng nhập có thể vẫn đang học qua tài liệu in, trao đổi trực tiếp hoặc sử dụng kênh khác nhưng không xuất hiện đầy đủ trong dữ liệu.
Sai lệch này có thể xuất hiện dưới nhiều dạng:
· Một nhóm người học có tỷ lệ xuất hiện cao hơn thực tế
· Người học bỏ cuộc hoặc ngừng sử dụng hệ thống bị loại khỏi dữ liệu
· Chỉ những người hoàn thành khảo sát mới được phân tích
· Một khóa học hoặc cơ sở đào tạo được dùng làm đại diện cho nhóm rộng hơn
Điểm cần lưu ý là một tập dữ liệu lớn chưa chắc đã đại diện. Hàng triệu bản ghi vẫn có thể tạo ra kết luận sai nếu chúng chủ yếu đến từ một nhóm có đặc điểm khác biệt.
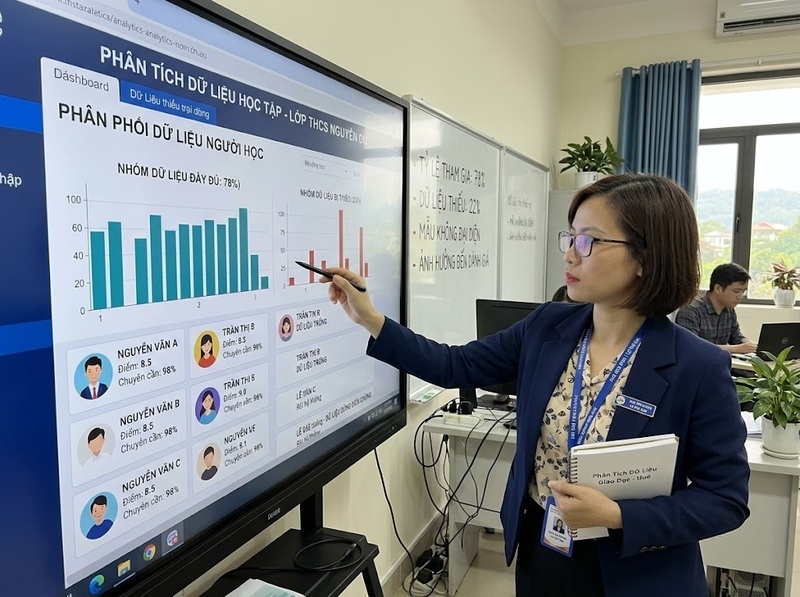
Sai lệch do dữ liệu thiếu và người học không xuất hiện
Dữ liệu thiếu không phải lúc nào cũng ngẫu nhiên. Đây là nguyên nhân khiến kết quả phân tích dễ bị lệch mà người phân tích không nhận ra.
Chẳng hạn, những người gặp khó khăn trong học tập có thể ít hoàn thành khảo sát, ít truy cập hệ thống hoặc bỏ dở khóa học. Khi các bản ghi này biến mất, dữ liệu còn lại có xu hướng nghiêng về những người duy trì hoạt động tốt hơn.
Điều này tạo ra một vấn đề quan trọng: dữ liệu thiếu có thể chứa thông tin về chính hiện tượng đang được đo.
Một số câu hỏi cần kiểm tra là:
· Nhóm nào có tỷ lệ dữ liệu thiếu cao nhất
· Dữ liệu thiếu tập trung ở giai đoạn nào của quá trình học
· Người bỏ học có bị loại khỏi phân tích hay không
· Tỷ lệ hoàn thành dữ liệu có khác biệt giữa các nhóm người học hay không
Nếu người học có nguy cơ rời khỏi hệ thống cao cũng là những người dễ bị thiếu dữ liệu nhất, việc chỉ phân tích các bản ghi đầy đủ có thể làm kết luận trở nên quá tích cực.
Sai lệch đo lường và dùng biến đại diện không phù hợp
Dữ liệu học tập thường đo những thứ dễ ghi nhận thay vì đo trực tiếp năng lực hoặc mức độ hiểu biết.
Một hệ thống có thể ghi nhận rất chính xác:
· Số lần đăng nhập
· Thời gian xem tài liệu
· Số lần nhấp chuột
· Số bài tập đã nộp
· Số lần tham gia thảo luận
Nhưng các chỉ số này không đồng nghĩa hoàn toàn với việc người học đã hiểu kiến thức.
Ví dụ, thời gian ở trên một trang học tập lâu có thể là dấu hiệu của sự tập trung, nhưng cũng có thể do người học gặp khó khăn hoặc để cửa sổ mở mà không thực sự học. Tương tự, số lần đăng nhập cao không tự động chứng minh kết quả học tập tốt.
Sai lệch xuất hiện khi một biến đại diện bị coi như chính hiện tượng cần đo.
Do đó, cần phân biệt giữa:
· Hành vi được hệ thống ghi nhận
· Trạng thái nhận thức thực sự
· Kết quả học tập
· Nguyên nhân đứng sau hành vi
Một chỉ số có thể hữu ích để dự báo hoặc mô tả nhưng vẫn không đủ để khẳng định nguyên nhân hay chất lượng học tập.
Sai lệch theo nhóm, thời gian và cách tổng hợp dữ liệu
Hai nhóm người học có thể có kết quả tổng thể khác nhau không phải vì một nhóm kém hơn, mà vì cấu trúc dữ liệu của họ khác nhau.
Ví dụ, một lớp có nhiều sinh viên năm nhất, trong khi lớp khác có nhiều sinh viên đã có nền tảng. Nếu chỉ so sánh điểm trung bình mà không xét bối cảnh, kết luận có thể nhầm lẫn giữa khác biệt về trình độ đầu vào và hiệu quả giảng dạy.
Sai lệch cũng có thể xuất hiện khi dữ liệu được tổng hợp quá mạnh. Một xu hướng đúng ở cấp độ tổng thể có thể không đúng trong từng nhóm nhỏ. Ngược lại, một khác biệt quan sát được trong một nhóm có thể biến mất khi dữ liệu được gộp lại.
Thời gian cũng là một nguồn sai lệch đáng chú ý. Dữ liệu của đầu học kỳ, cuối học kỳ hoặc các giai đoạn trước và sau một thay đổi chương trình không nhất thiết có cùng ý nghĩa.
Khi phân tích, cần xem xét:
· Khác biệt giữa các nhóm người học
· Khác biệt về trình độ đầu vào
· Khác biệt giữa các thời điểm
· Thay đổi của chương trình hoặc phương pháp giảng dạy
· Cách dữ liệu được chia nhỏ hoặc tổng hợp
Sai lệch thuật toán và vòng lặp phản hồi
Ngay cả khi dữ liệu ban đầu tương đối đầy đủ, mô hình phân tích vẫn có thể tạo ra sai lệch.
Điều này xảy ra khi mô hình học từ các dữ liệu lịch sử vốn đã chứa chênh lệch giữa các nhóm. Nếu mô hình dự đoán một nhóm có nguy cơ kết quả thấp cao hơn, hệ thống có thể đưa nhóm đó vào các can thiệp hoặc quyết định khác với nhóm còn lại. Những quyết định này lại tạo ra dữ liệu mới, rồi dữ liệu mới tiếp tục được dùng để huấn luyện hoặc đánh giá mô hình.
Đây là một vòng lặp phản hồi:
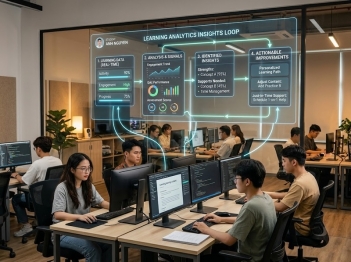
Dữ liệu lịch sử → Mô hình → Quyết định → Hành vi mới → Dữ liệu mới
Nếu không kiểm soát, mô hình có thể củng cố một khuôn mẫu sẵn có thay vì chỉ phản ánh thực tế.
Một vấn đề khác là sử dụng quá nhiều biến dễ đo nhưng có liên hệ với đặc điểm nhóm người học. Khi đó, mô hình có thể đưa ra dự đoán có vẻ chính xác nhưng khó giải thích về mặt giáo dục.
Sai lệch do cách diễn giải dữ liệu
Không phải mọi sai lệch đều nằm trong bản thân dữ liệu. Sai lệch còn có thể xuất hiện khi người phân tích chuyển dữ liệu thành kết luận.
Một số lỗi thường gặp là:
· Nhầm tương quan với quan hệ nhân quả
· Chọn chỉ số thuận lợi rồi bỏ qua chỉ số bất lợi
· Chỉ nhìn trung bình mà bỏ qua phân bố
· Kết luận về toàn bộ người học từ một nhóm nhỏ
· Xem một thay đổi theo thời gian là bằng chứng về hiệu quả của một can thiệp
· Bỏ qua các yếu tố nền có thể giải thích kết quả
Ví dụ, nếu nhóm học sinh có điểm cao dành nhiều thời gian cho một hoạt động học tập, chưa thể kết luận rằng hoạt động đó đã làm điểm tăng. Có thể những học sinh vốn đã có động lực cao cũng là những người dành nhiều thời gian hơn cho hoạt động này.
Vì vậy, một kết quả thống kê đáng chú ý vẫn cần được đặt trong đúng bối cảnh trước khi trở thành kết luận giáo dục.
Cách kiểm tra sai lệch dữ liệu học tập trước khi kết luận
Một quy trình kiểm tra có thể bắt đầu từ bốn câu hỏi:
1. Ai đang xuất hiện trong dữ liệu và ai đang bị thiếu?
2. Kiểm tra mức độ đại diện của mẫu, tỷ lệ bỏ cuộc và dữ liệu thiếu giữa các nhóm
3. Biến đang đo thực sự phản ánh điều gì?
4. Phân biệt hành vi được ghi nhận với năng lực, mức độ hiểu hoặc kết quả học tập
5. Kết quả có thay đổi theo nhóm và thời điểm không?
6. So sánh các nhóm thay vì chỉ nhìn số liệu tổng hợp
7. Kết luận có vượt quá những gì dữ liệu chứng minh không?
8. Đặc biệt kiểm tra các kết luận về nguyên nhân, hiệu quả và dự báo
Một phân tích đáng tin cậy không chỉ hỏi “kết quả là gì” mà còn phải hỏi “kết quả này có thể bị tạo ra bởi sai lệch nào”.
Các sai lệch dữ liệu học tập có thể xuất hiện từ khâu chọn mẫu, thu thập, đo lường, xử lý, mô hình hóa cho đến diễn giải. Sai lệch lớn nhất không nhất thiết là một giá trị dữ liệu sai; đôi khi đó là một tập dữ liệu hoàn toàn chính xác nhưng chỉ phản ánh một phần thực tế. Vì vậy, trước khi dùng dữ liệu để đánh giá người học, chương trình hoặc hiệu quả giảng dạy, cần kiểm tra dữ liệu đại diện cho ai, đang đo điều gì, thiếu gì và kết luận có vượt quá bằng chứng hay không.

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm